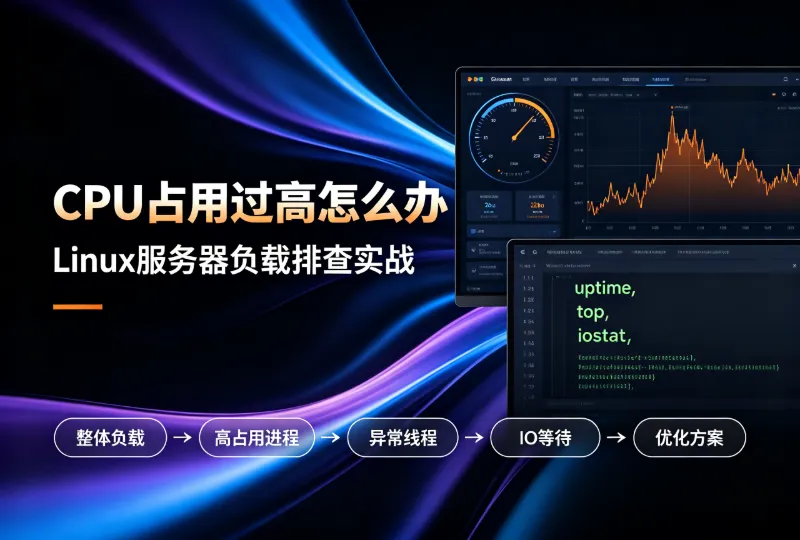
在日常运维过程里,Linux服务器CPU负载上涨是很常见的情况。服务响应变慢、网站打开延迟、后台任务卡住、本地AI推理进度拖沓,很多时候都和CPU资源占用异常有关系。下面整理一套可落地的排查思路,适配CentOS、Ubuntu这类主流发行版,一步步找到负载异常的根源,再根据情况做调整处理。
一、先查看服务器整体负载
排查之前,优先看整机负载,判断只是短暂波动,还是持续存在的异常。
SSH终端输入这条指令:
返回结果会展示1分钟、5分钟、15分钟的平均负载,可以这样参考:
- 负载数值小于CPU核心数量,属于正常区间
- 短时间负载抬升,大多是临时任务、瞬时访问波动带来的
- 长时间负载居高不下,说明有进程持续消耗资源,需要继续往下排查
二、使用top工具定位高负载进程
top是系统自带的实时资源查看工具,用来观察CPU和内存占用,排查这类问题经常会用到。
输入命令进入监控面板:
面板内可以用快捷键切换排序方式:
- 按下 P:按CPU占用排序,优先看到消耗资源多的进程
- 按下 M:切换为内存占用排序
- 按下 q:退出top界面
重点看懂这几个状态字段,用来区分故障方向:
- us 用户态CPU:业务程序、自定义脚本、容器、后台任务产生的开销
- sy 内核态CPU:内核调度、文件读写、底层系统操作带来的占用
- id 空闲CPU:剩余可用算力,数值偏低代表资源紧张
- wa IO等待:磁盘读写阻塞引发的等待,并不是CPU本身在大量运算
三、静态列出占用靠前的进程
如果不想用交互式top,也可以直接执行下面这条,一次性输出CPU占用靠前的进程,方便复制记录分析。
返回信息包含进程所属用户、资源占比、启动命令,能够初步分辨是业务程序、定时任务,还是不知名进程造成负载上涨。
四、深入排查,找到异常线程
不少服务采用多线程运行,整个进程占用很高的时候,需要定位里面哪一条线程在持续消耗资源。把指令里PID替换成你查到的进程编号即可。
也可以选择这条查看线程信息:
Python脚本、容器内程序、AI推理服务、常驻后台程序,很多高负载问题都是单线程循环运算导致,这一步可以缩小排查范围。
五、三类高负载情况分别处理
1、用户态CPU偏高
这种情况属于业务层面问题,遇到的频率更高,常见诱因有这些:
- 本地模型推理、后台循环程序持续运行
- 网站访问量上升,服务处理压力变大
- 脚本逻辑考虑不周,出现反复循环执行
- 定时任务设置得比较密集,频繁拉起脚本
处理思路:查看程序日志,查找报错和逻辑异常;暂停暂时不用的后台任务;调整并发参数;对无响应进程执行终止。常规kill无效时,再使用强制终止方式。
2、内核态CPU偏高
内核占用高和业务代码关系不大,一般是系统底层因素引发:
- 磁盘读写频繁,大量新建、删除文件
- 文件系统存在异常
- 内核频繁做资源调度切换
用iostat观察磁盘IO状态:
查看内核报错信息,确认硬件、系统层面问题:
如果看到磁盘报错、硬件异常提示,优先处理底层故障,不要随意结束系统进程。
3、IO等待wa数值偏高
wa高的时候,CPU本身是空闲的,负载高只是因为磁盘读写跟不上,程序卡在IO等待上。
可以这样优化:减少大批量读写操作,关掉频繁刷日志的功能,清理不必要的自动备份,检查修复文件系统,存储性能不足时可以考虑更换适配的硬盘。
六、几个高频场景的处理办法
1、Docker容器内部CPU占用异常
很多服务器负载问题源头藏在容器里面。先查看全部容器资源占用:
进入对应容器内部继续排查进程:
平时给容器设置资源上限,避免单个容器吃光整机算力,保障其他服务稳定运行。
2、定时任务带来持续高负载
不合理的定时规则、重复脚本、自启动的陌生任务,都会长期拉高CPU。查看当前用户定时任务:
同时翻看系统全局定时目录,清理掉陌生、频繁触发、没有实际用途的脚本。
3、陌生进程持续占用资源
外网服务器防护不到位,容易出现不明后台进程,这类进程大多配置了自启动,单纯杀掉进程会再次出现。
排查方向:查看进程启动命令,检查临时目录里可疑文件,清理异常自启动项和定时任务,补齐服务器安全策略。
七、长期维持稳定的优化方式
- 设置资源配额:给常驻服务、容器、推理程序加上资源限制,防止单一程序抢占过多算力
- 规范日志输出,关闭冗余日志打印,降低磁盘IO开销
- 做好安全配置,关掉不用的外网端口,配置防火墙规则,降低恶意程序入侵概率
- 部署监控告警,及时发现负载异常,提前处理,避免业务长时间卡顿
- 优化程序逻辑,修正脚本循环bug,合理控制并发规模
总结
Linux服务器CPU负载高,不用上来就重启服务器或者随便杀进程。推荐顺序是:查看整机负载、定位高占用进程、检查线程详情、区分用户态/内核态/IO问题,再结合场景处理。顺着这套流程排查,大多负载异常问题都可以妥善解决,让业务和后台服务平稳跑起来。





暂无评论内容