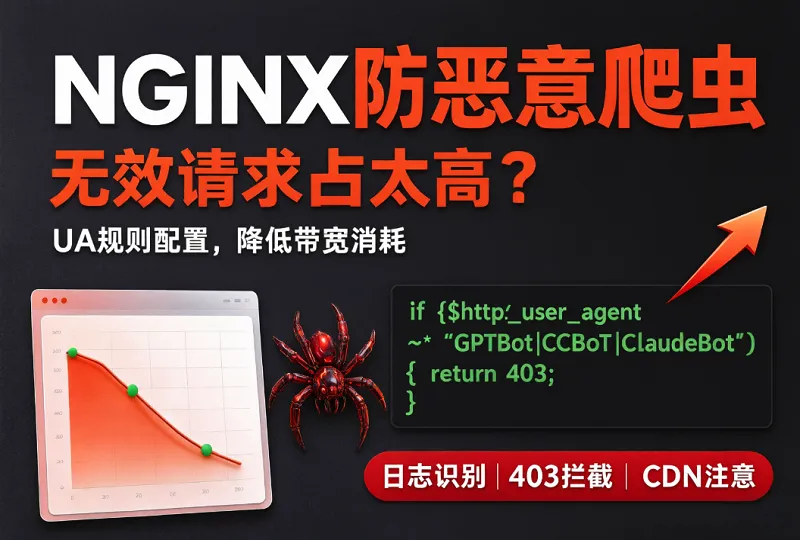
不少站长都会遇到一个问题:网站流量看着不低,但没有带来实际访问转化,服务器带宽、CPU资源却持续被占用。排查访问日志后会发现,大量请求来自各类垃圾爬虫、AI采集蜘蛛,这类爬虫只抓取页面内容,不会产生真实用户访问,持续消耗服务器资源。
通过Nginx配置用户代理UA拦截规则,可以对这类无效爬虫做访问限制,减少不必要的请求,降低服务器负载。下面分享实操配置方式,以及配置完成后的验证方法。
一、先区分正常爬虫和恶意采集爬虫
搜索引擎官方爬虫,比如百度、神马的蜘蛛,属于正常抓取,不建议直接拦截。拦截的目标是各类批量采集爬虫、AI内容抓取机器人、无效扫描爬虫。
在编写拦截规则前,建议先查看Nginx访问日志,确认哪些UA在高频访问站点。Nginx默认日志路径一般为 /var/log/nginx/access.log,可以通过日志定位高频爬虫标识。
查看日志命令:
tail -n 200 /var/log/nginx/access.log从日志里提取爬虫UA名称,再加入屏蔽列表,不要直接复制网上一大段通用规则直接上线,通用规则容易误杀正常访问。
二、Nginx配置UA白名单与拦截规则
规则可以放在站点server块内部,或者单独新建conf文件引入,方便后续维护。
打开网站对应的Nginx配置文件,在server{}内部加入下面代码:
# 搜索引擎白名单:百度、谷歌、必应、神马
if ($http_user_agent ~* "Baiduspider|Googlebot|bingbot|Sogou|360Spider|YisouSpider|HaosouSpider|Sosospider|Sogou web spider|Sogou inst spider|Sogou Pic Spider|Sogou News Spider|Sogou Video Spider|Sogou Mobile Spider|Sogou Orion spider|360spider|SogouSpider2.0|Baiduspider-image|Baiduspider-video|Baiduspider-news|Baiduspider-render|Baiduspider-mobile|Googlebot-Image|Googlebot-Mobile|Googlebot-News|Mediapartners-Google|AdsBot-Google|bingbot/2.0|Slurp|DuckDuckBot|Baidu-YunGuanCe|Shenma-Spider|YandexBot") {
    set $is_good_bot 1;
}

# 恶意采集爬虫黑名单
if ($http_user_agent ~* "GPTBot|CCBot|ClaudeBot|anthropic-ai|Google-Extended|FacebookBot|Applebot-Extended|Omgili|Scrapy|AhrefsBot|SemrushBot|MJ12bot|DotBot|Bytespider|PetalBot|Barkrowler|BLEXBot|MauiBot|Rogerbot|HTTrack|python-requests|Go-http-client|libwww-perl|sqlmap|nikto|masscan|acunetix|zgrab|curl|wget|PostmanRuntime|Apache-HttpClient") {
    set $is_bad_bot 1;
}

# 白名单优先:如果是正常搜索引擎蜘蛛,直接放行
if ($is_good_bot = 1) {
    break;
}

# 黑名单拦截:恶意爬虫返回403
if ($is_bad_bot = 1) {
    return 403;
}
代码含义:先判断请求UA是否属于白名单中的搜索引擎蜘蛛,如果是则直接放行,跳过后续拦截逻辑;否则再判断是否命中黑名单,命中则返回403禁止访问。
白名单覆盖了百度蜘蛛(含图片、视频、新闻、移动端等变体)、谷歌蜘蛛(含图片、移动端、广告相关)、必应、搜狗、360、神马等国内主流搜索引擎。
黑名单覆盖了AI采集爬虫、SEO工具爬虫、批量采集工具、扫描器等。可以根据自己日志里抓到的爬虫,在黑名单引号内继续补充UA关键词,多个关键词用管道符 | 分隔。
注意:Nginx的 if 指令在部分场景下存在隐患,但此处仅使用 set、break、return 是安全的。不要在 if 块内使用 rewrite、proxy_pass 等指令,否则可能出现不可预期的行为。
配置完成之后,一定要先检测配置语法,避免Nginx重启失败导致网站无法访问。
nginx -t输出test is successful代表语法无误,再重载Nginx配置。
nginx -s reload三、robots.txt补充配置(辅助限制)
Nginx规则是直接拦截请求,robots.txt只是给爬虫的指引文件,不具备强制拦截能力,很多采集爬虫会无视robots规则,两者搭配使用效果更好。
在网站根目录新建robots.txt,写入下面内容:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: FacebookBot
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: PetalBot
Disallow: /
注意:不要在robots.txt中对百度、谷歌等正规搜索引擎设置 Disallow: /,否则会影响网站收录。robots配置不会阻止无视协议的爬虫,但可以给合规爬虫传递抓取限制指令。
四、配置完成,本地测试拦截效果
配置上线后,需要验证规则是否生效,使用curl模拟爬虫UA发起请求。建议加上 -I 参数只获取响应头,避免下载完整页面浪费带宽:
curl -I -A "GPTBot" https://你的域名如果返回403,说明拦截规则正常工作。如果返回200,代表规则没有生效,需要检查Nginx配置文件位置,确认是否放置在正确的server块内。
同时模拟百度蜘蛛和谷歌蜘蛛访问,确认白名单蜘蛛不会被误拦截:
curl -I -A "Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)" https://你的域名curl -I -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://你的域名正常应返回200。再模拟正常浏览器UA访问,确认普通用户访问不会被误拦截:
curl -I -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36" https://你的域名五、实操注意事项
- 不要一次性添加大量UA关键词上线,分批添加,上线后观察访问日志,防止误拦截正常蜘蛛或用户。
- 部分爬虫会伪造UA,伪装成浏览器访问,UA拦截无法处理这类情况,遇到高频伪造爬虫,可以结合IP访问频率限制做补充防护。
- CDN环境下,需要确认CDN是否传递原始UA头。如果CDN回源时覆盖了UA头,Nginx侧的
$http_user_agent将拿到CDN的UA而非原始UA,此时需在CDN控制台通过”请求头匹配”规则直接拦截,而非依赖源站Nginx。 - 定期查看站点访问日志,持续新增新出现的采集爬虫标识,规则不是一次性配置就永久生效。
- 白名单中的搜索引擎蜘蛛UA也可能被伪造,如需更严格的防护,可结合IP反向DNS解析进行二次验证。真实百度蜘蛛IP反向解析结果以
*.baidu.com或*.baidu.jp结尾,谷歌蜘蛛IP需包含googlebot.com特征。
六、小结
针对无效爬虫的防护,优先依靠日志识别目标爬虫,再通过Nginx的UA白名单+黑名单规则拦截,搭配robots.txt做辅助声明。这套方案可以减少无效请求占用带宽与服务器算力,减轻站点负载。如果站点接入CDN,优先在CDN层面配置拦截,减少回源消耗。
爬虫防护没有一劳永逸的方案,需要持续观察站点访问日志,根据实际访问情况调整拦截名单。
如果你在 CDN 环境配置遇到抓取异常,可以参考本站另一篇《EdgeOne CDN搜索引擎蜘蛛抓取排错教程》。





暂无评论内容